为人机交互与数字创作,
赋予
人性的温度。
 悟声
一个平台,完成全部的声音创作。
配音、声音设计、变声、音乐、音效、多轨编排与视频翻译,都在同一个工作台里完成。
多角色台本里的每一句都可以单独选择音色、写下表演指令、重新生成。
Voice4.0
克隆、声音设计与开放域的导演控制,第一次在同一个模型里完成。它会自己读懂文本的情绪;想要更精确时,在文本里写下一句表演指令就够了。
{{轻柔,贴近麦克风}}别担心,我在这儿。
{{兴奋地}}我们中了!{{突然压低声音}}……先别告诉别人。
{{用东北口音}}这事儿整得挺好,没毛病。
模型矩阵
09所有模型都基于我们自己的基座训练。从语音、音乐、音效、视频翻译与实时对话,到 3D 交互与音频安全。
自主控制每个身体动作的3D AI 角色。
元语 T1.0 用一个端到端模型同时生成文本、语音与 3D 动作:角色开口说话的同时,身体也在做与语义贴合的动作。它让虚拟角色可以自主地聊天、直播与互动。
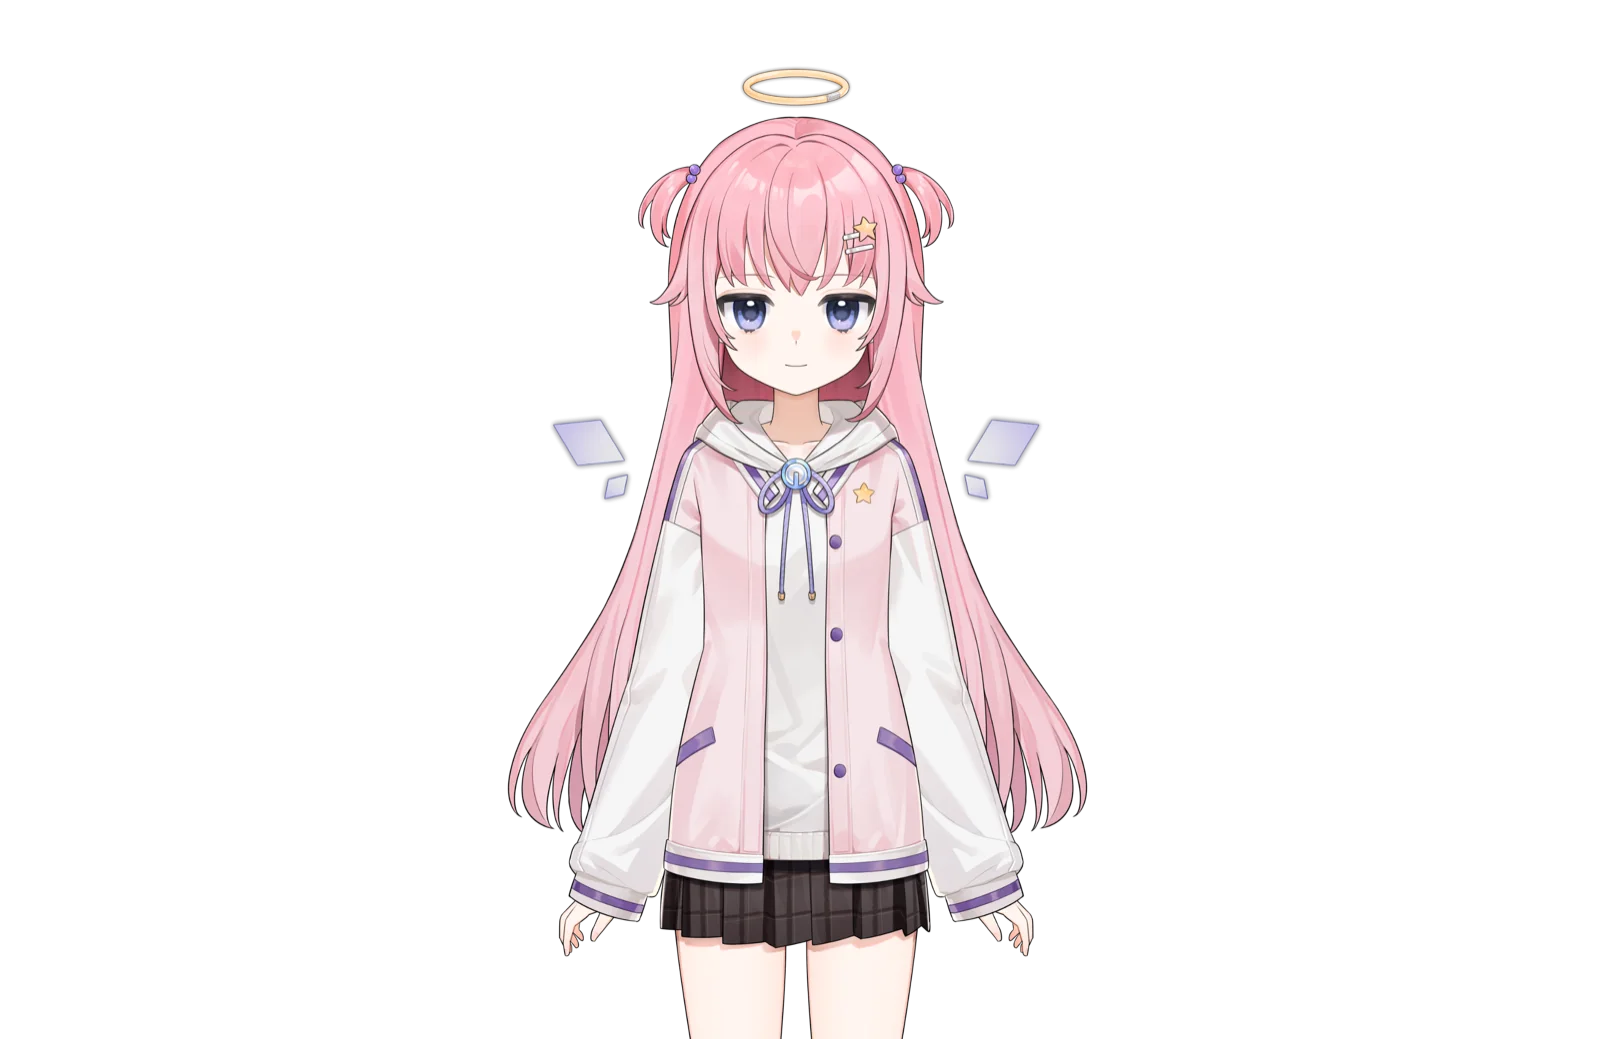
木几萌是一位完全由 AI 驱动的虚拟主播。2022 年末她在 B 站首次开播,自己聊天、自己唱歌,回应每一条弹幕,是全球最早由 AI 自主直播的虚拟主播之一。开播不久,她便登上了百度贴吧全站热搜与 B 站全站增长榜。
她的声音、对话与动作,由我们自研的元语模型驱动。
- 2022
- 年末首次开播
- Top 9
- B 站全站增长榜
- 2万+
- 最高单日涨粉
把同一套模型,接进你的产品。
REST 与 WebSocket 接口,Python、JavaScript、.NET、Swift SDK,全球节点就近接入。也支持品牌音色定制与私有化部署。
const stream = await vocu.tts.stream({model: 'voice-4.0',voice: 'brand-assistant',text: '{{轻快}}你好,很高兴见到你。',});for await (const chunk of stream) {player.write(chunk);}
有声书、播客、广播剧、短视频与课程配音。多角色、导演式演绎,长篇里音色始终稳定。
视频一键译配。换一种语言,仍然是原演员的声音与情绪。
角色配音、NPC 实时对话、虚拟主播与互动直播。
语音助手、客服与通知播报。流式低延迟,中英混读,数字与地址读得准。
以技术之矛,炼就技术之盾。
生成能力越强,越需要可靠的标识与鉴别。我们自研的水印与鉴伪模型,和生成模型一起设计、一起迭代。
音频隐形水印:无损注入、人耳不可感知;经翻录、剪辑、格式转换后,仍可读出用户 ID、任务 ID 与生成时间。
鉴伪专家大模型:以数百万小时级伪造数据训练,泛化检测各类音频合成技术的生成结果。
悟声 · 元语 双大模型备案
最新动态